KDD 2027 (Oral)
作者: Sirry Chen、Fangke Chen、Xuanwen Ding、Wei Chen、Zhongyu Wei
- 论文:arXiv · PDF
- 代码:GitHub
- 交互演示:ClinVerse Demo
- 公众号推送:微信公众号
1. 引言:会做医学题,等于会问诊吗?
静态医学问答通常先把病史和检查结果交给模型,再让它给出答案。但在一次诊断开始时,医生往往只知道患者的主诉。哪些信息需要追问?什么检查有助于区分几个可能的诊断?证据收集到什么程度,可以结束问诊?这些决定会改变后续能看到的证据,也是只看最终答案时容易漏掉的能力。
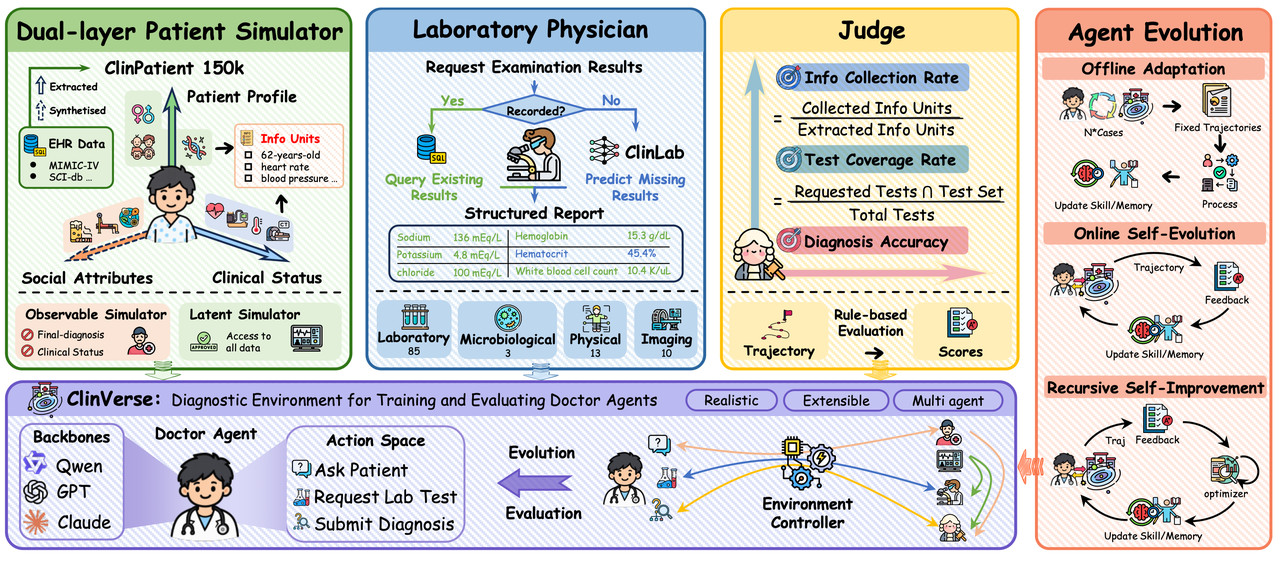
为此,我们提出 ClinVerse:一个以电子健康记录(EHR)为基础的交互式诊断环境。医生智能体从有限的初始信息出发,通过问诊和检查逐步获取证据,最后提交诊断。环境记录整段交互,使同一套病例既可以用来评测智能体,也可以用来检验它是否能从先前的交互中学习。
2. 一次模拟问诊是怎样进行的?
2.1 六个角色,各自掌握不同的信息
| 角色 | 在模拟中的职责 |
|---|---|
| 医生智能体 | 根据当前证据决定继续追问、申请检查,还是提交诊断。 |
| 环境控制器 | 路由医生的动作,记录哪些信息已经获得。 |
| 可观测患者模拟器 | 回答患者自己能描述的问题,例如症状、既往史和用药情况。 |
| 潜在患者模拟器 | 维护完整病例状态,向有权限的角色提供信息,不直接回答医生。 |
| 检验医师 | 接收检查请求,返回已有或模拟的检查报告。 |
| 诊断评估器 | 根据交互记录和病例参考信息,为整段轨迹评分。 |
2.2 为什么把患者模拟拆成两层?
如果同一个患者智能体既要扮演患者,又能看到完整病历,它可能在一次追问中提前泄露诊断或尚未完成的检查结果。我们把患者可自述的信息与后台病例状态分开,并对回答做自检。这样可以让新证据通过问诊或检查逐步出现,降低患者回答提前泄露参考答案的风险。
3. 病例从哪里来?缺失检查怎么处理?
3.1 ClinPatient:把病历转成可交互病例
我们从电子健康记录中构建了约 15 万例 ClinPatient 病例。构建过程将主诉、症状、既往史等内容拆成可追踪的信息单元,并把检查结果组织为可按请求返回的记录。病例开场只给出一部分信息;其余证据在交互中按规则逐步开放。
3.2 ClinLab:为未记录的检查提供模拟结果
原始病历只记录了当时做过的检查。当医生智能体申请一项检查时,环境优先返回已有记录;如果记录缺失,再由 ClinLab 根据病例上下文生成模拟结果。这样可以让智能体尝试不同的检查路径,也减少它把“某项检查没有记录”当成诊断线索的机会。
4. 怎么评测:把过程和结果分开看
ClinVerse 在问诊结束后用规则对照结构化病例证据和 ICD-10 参考标签,分别统计以下指标:
| 维度 | 指标 | 看什么 |
|---|---|---|
| 问诊 | ICR | 获得了多少病例中的患者信息。 |
| 检查 | TOC、ATC | 覆盖了多少参考检查,其中又覆盖了多少异常检查。 |
| 诊断 | DCA、DSA | 预测在 ICD-10 类别与更细粒度编码上分别是否匹配。 |
把这些分数放在一起,能区分两种容易被最终准确率掩盖的情况:一个智能体找到了不少相关证据,却没有据此做出正确诊断;另一个给出了正确编码,但并没有充分获取证据。它们的改进方向不同。
4.1 问诊轨迹:新信息来得早,诊断还会继续变化
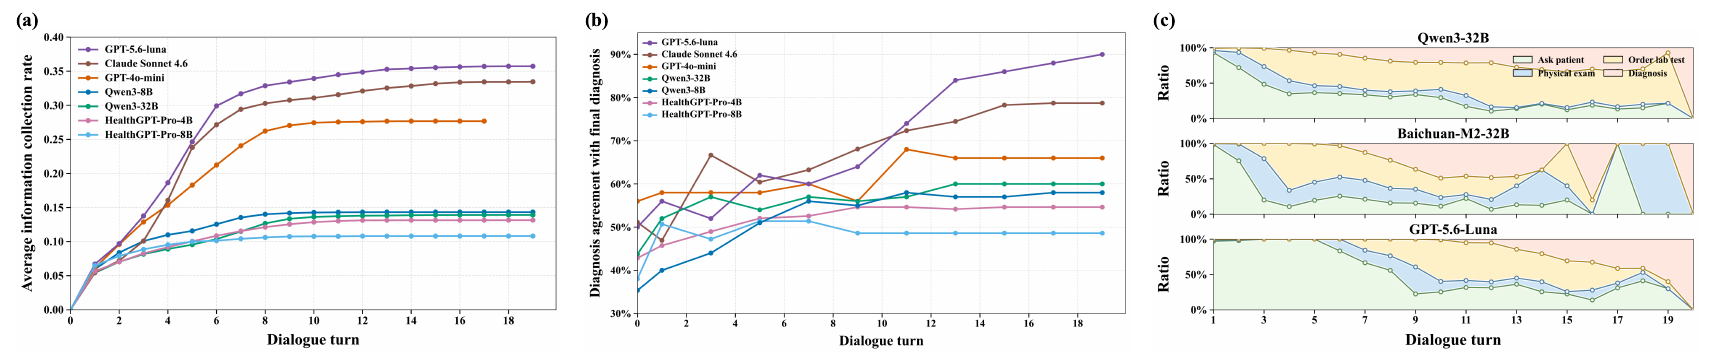
图 3(a) 显示,多数模型在问诊前几轮就收集到了大部分最终获得的患者信息,之后新增信息逐渐变少。图 3(b) 中,即使信息收集曲线趋平,一些模型的中间诊断仍会逐步接近最终诊断。这说明后几轮的作用可能更多是整合、复核已有证据。这里的一致性指中间诊断与最终诊断的匹配程度。
从图 3(c) 看,三种模型大体都从追问起步,在中段更多使用查体和检验,最后提交诊断,但切换动作的节奏各不相同。有了逐轮记录,就能进一步检查模型在哪一步开始遗漏证据,或者为什么过早停止问诊。
5. 智能体能从问诊轨迹中学习吗?
我们在同一个环境里比较了三类方法:离线适配从已有轨迹中提取经验,在线自演化在新的交互中更新经验,递归自改进则根据反馈反复调整策略。
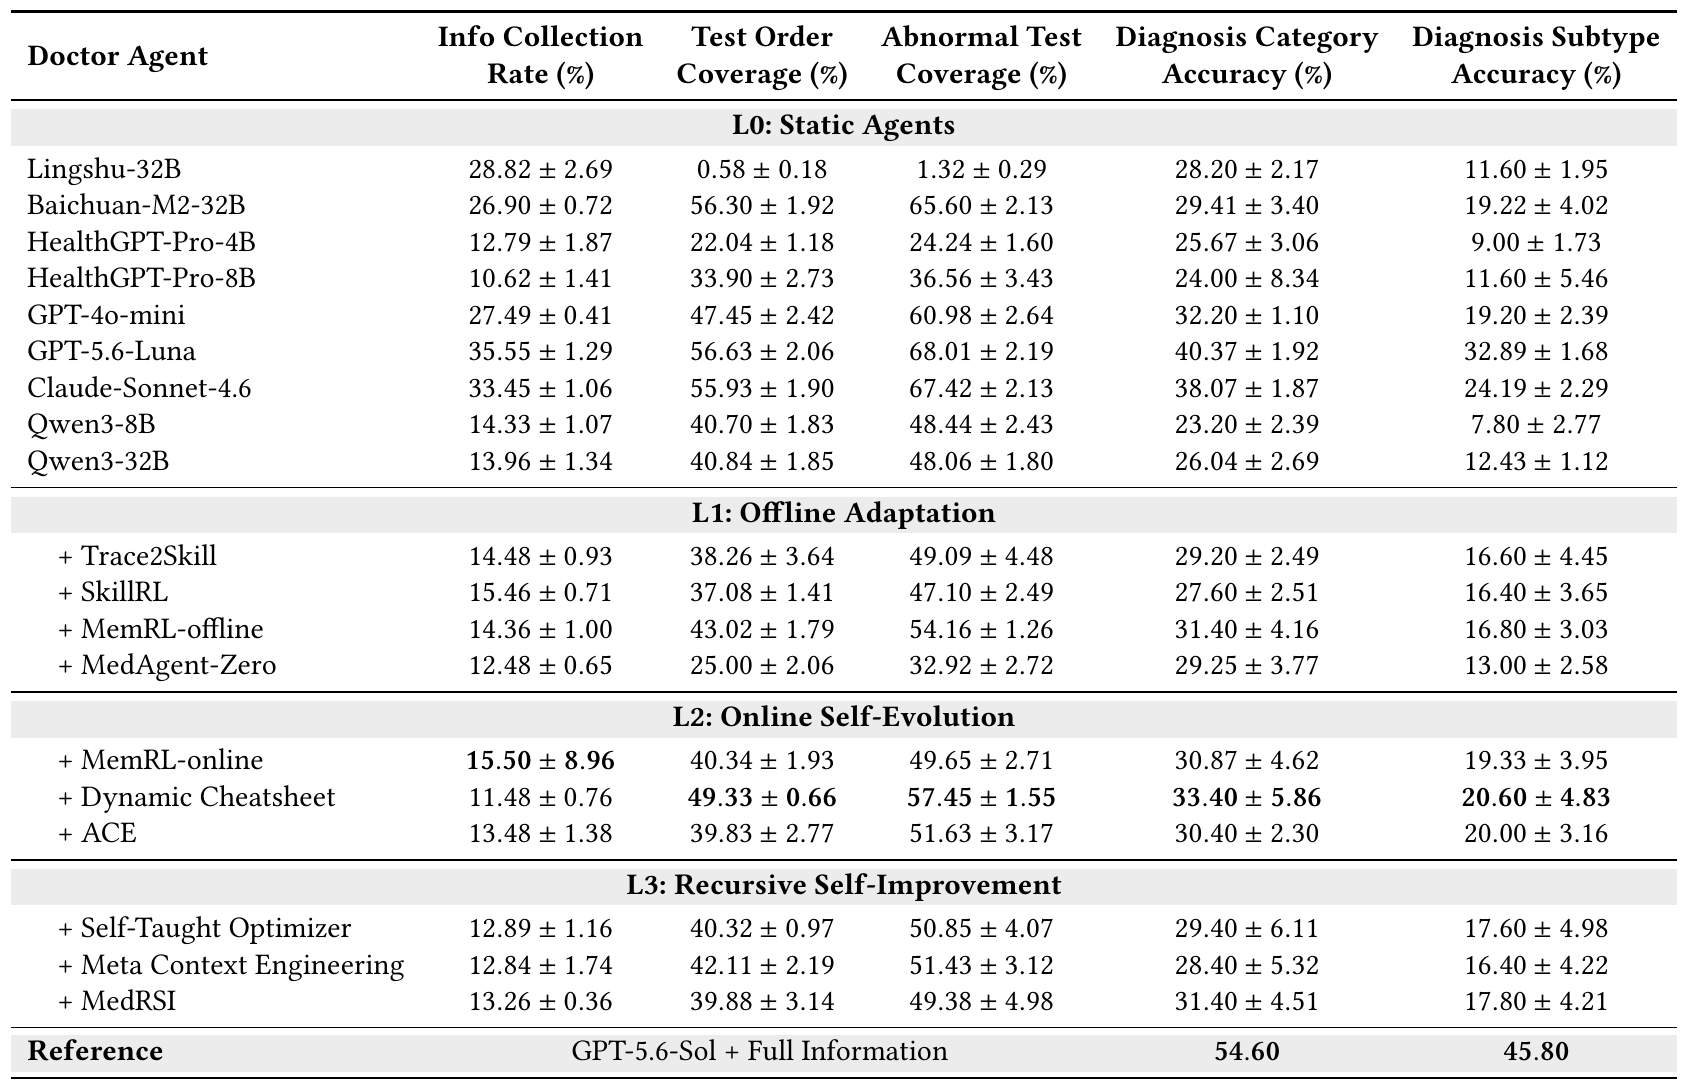
表 2 给出了一个直观例子:以 Qwen3-32B 为基础,Dynamic Cheatsheet 将细粒度诊断准确率从 12.43% 提高到 20.60%,同时提高了检查覆盖率和异常检查覆盖率,但患者信息收集率有所下降。这个结果提示我们,改进诊断未必需要问更多问题;也可以通过改变取证顺序,获得更有用的证据。
5.1 收集更多信息,诊断一定会更准吗?
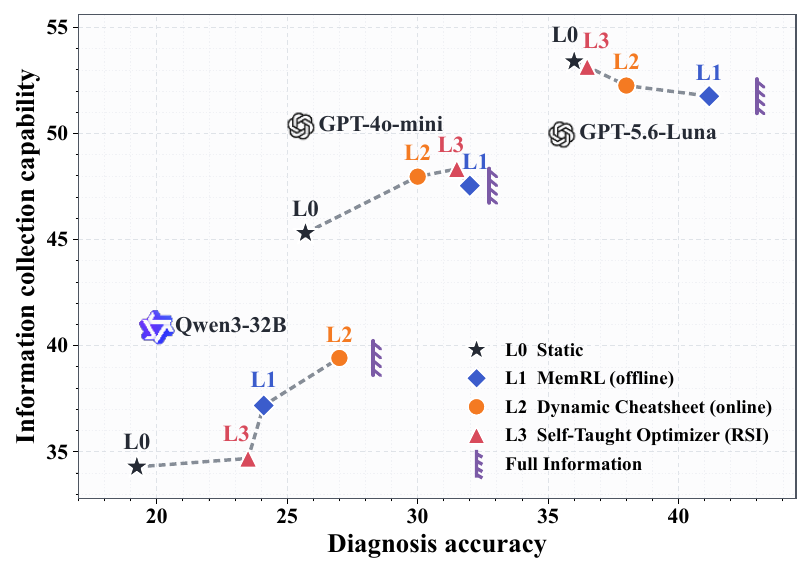
不同模型的变化方向并不一样:Qwen3-32B 的若干改进同时提高了信息获取和诊断分数;GPT-5.6-Luna 在图中部分方法下,即使信息获取的综合分数下降,诊断分数仍有提高。因此,训练后的智能体是否更善于挑选和利用证据,值得与“它获取了多少信息”分开考察。
5.2 跨模型学习:训练轨迹来自哪个模型,有什么影响?
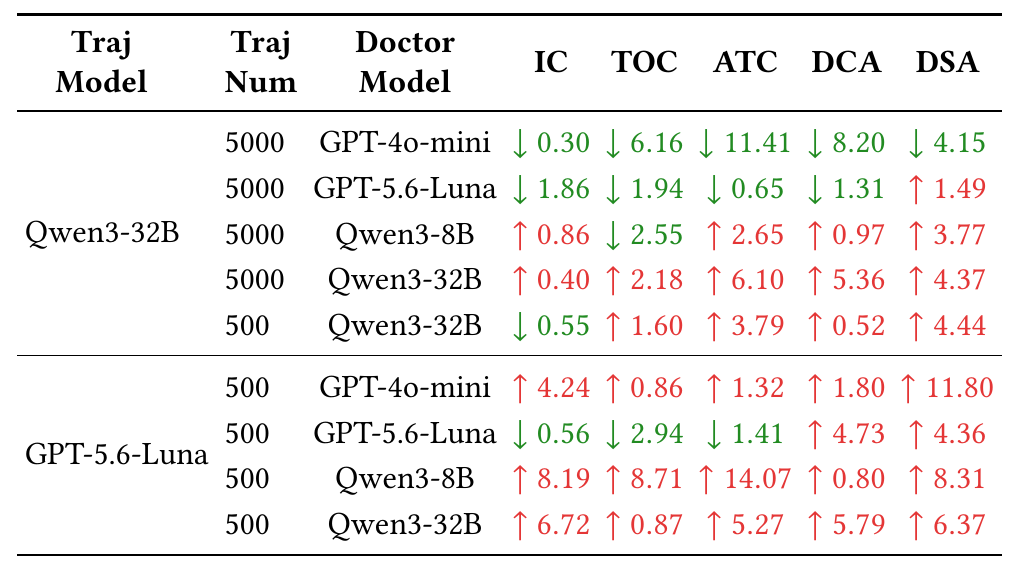
以 Qwen3-32B 为目标模型,使用 GPT-5.6-Luna 生成的 500 条问诊轨迹训练后,细粒度诊断准确率提高 6.37 个百分点;使用 Qwen3-32B 自身生成的 5,000 条轨迹时,提高 4.37 个百分点。不过,后者在检查覆盖率和异常检查覆盖率上的提升更大。这组结果表明,轨迹来源和数量都会影响训练效果,具体收益还要分指标来看。
6. 投稿期间的观察:为什么我们更看好模拟医疗环境?
在这项工作投稿期间,我们陆续读到了许多尝试模拟真实医疗过程的研究。Evolving Interactive Diagnostic Agents in a Virtual Clinical Environment 利用虚拟临床环境训练和评估多轮诊断策略;Sequential Diagnosis with Language Models 把病例变成逐步揭示证据的诊断任务,并同时考察准确率与检查成本;Towards autonomous medical artificial intelligence agents 则让 MIRA 在隔离的电子健康记录环境中执行更广泛的临床操作。
这些工作各有侧重,却让我们看到了同一条研究路径:当环境能对追问、检查和决策给出反馈时,我们就能观察模型如何得到答案,比较不同策略的取舍,并把发现的问题转化为训练目标。这些进展让我们更有信心,构建贴近真实流程的模拟医疗环境,是促进医疗 AI 发展的重要途径。